序章
之前的单字识别做的是判别问题:给一张图,从 7356 个类里挑一个。这次反过来了——想生成一张图。
生成模型的几条主流路线各有各的贵。GAN 要训一个判别器,博弈不稳定;扩散模型效果好,但生成要跑几十步去噪;VAE 出来的是模糊均值。今年看到 “Generative Modeling via Drifting”(arXiv:2602.04770)的时候被它的简洁吸引住了:训练时只需要一个 drifting 场,生成时一次前向传播,没有判别器,没有去噪链。
想法不复杂:把生成样本 x 往数据点的方向”拉”(吸引),同时让生成样本之间互相”推”(排斥),两个力来自同一个核函数。当推拉平衡时分布对齐,场 V 处处为零。训练就是让网络回归 x → x + V 这个被冻结的目标。
于是写了一个 mixdrift 包复现它的条件生成部分,目标是手写汉字。实验环境:RTX 4050 6GB / 10GB RAM,全程在笔记本上跑。这篇文章记录架构设计和实验过程——包括一连串失败,最后一个像素空间的小结果。
第一章:drifting 场的原理与实现
反对称场
论文的核心是 Algorithm 2 那个反对称 drifting 场。给定一批生成样本 gen(兼任负样本)和一批数据样本 pos:
- 算两组距离:gen 到 pos 的距离、gen 彼此之间的距离
- 拼成一个 logit 矩阵过 softmax,行方向和列方向各 softmax 一次,取几何平均得到核矩阵 a
- 吸引力 = a 加权的数据均值,排斥力 = a 加权的生成样本均值,V = 吸引 − 排斥
这个设计有个关键性质:分布完全匹配时 V = 0,场自己就是收敛判据。温度 τ 控制核的软硬,τ ≤ 0 时用 τ = 0.05 · 平均距离 自适应——这一点在换维度的时候救命,2D 和 4096d 的距离尺度完全不同。
实现出来比想象中短:
def compute_drift(gen, pos, temp=0.05, temp_frac=0.05):
    dist_pos = torch.cdist(gen, pos, p=2)
    dist_neg = torch.cdist(gen, gen, p=2)
    dist_neg = dist_neg + torch.eye(len(gen)) * 1e6  # 排除自己

    if temp <= 0:
        temp = temp_frac * dist_pos.mean().clamp_min(1e-6)

    logit = torch.cat([-dist_pos / temp, -dist_neg / temp], dim=1)
    a = (logit.softmax(dim=1) * logit.softmax(dim=0)).sqrt()
    a_pos, a_neg = a.split([pos.shape[0], gen.shape[0]], dim=1)
    w_pos = a_pos * a_neg.sum(dim=1, keepdim=True)
    w_neg = a_neg * a_pos.sum(dim=1, keepdim=True)
    return w_pos @ pos - w_neg @ gen


def drifting_loss(gen, pos, **kwargs):
    with torch.no_grad():
        drift = compute_drift(gen, pos, **kwargs)
        target = gen.detach() + drift
    loss = (gen - target).pow(2).mean()
    return loss, drift.norm(dim=1).mean()
注意 loss 的形式:回归的目标是 stop-gradient 的 x + V,场本身不传梯度。网络学的不是”往哪走”,而是”从当前位置走一步之后的落点”。这个间接性是整篇方法最反直觉的地方,也是后面一系列失败的伏笔。
为什么先做 2D toy
在把 GPU 时间烧在图像上之前,先写了个 toy_2d.py 在两个经典点云上做 sanity check:棋盘和瑞士卷。棋盘是多峰分布的试金石——8 个模式只要有一个没出来,说明排斥项没起作用;瑞士卷考察流形贴合。
结果完美:runs_mixdrift_toy_v4/ 里棋盘 8 个模式全部出来,瑞士卷精确贴合。loss 实现确认无误,可以进图像了。
事后看,这个 toy 的成功还埋着一条重要信息:2D 里 z → 最近簇的指派函数是平滑的,小网络拟合得起。 当时没意识到这句话在图像空间会变成什么样。
第二章:数据与生成器
数据
手写汉字还是从 HWDB 来,写了 prepack_noisy.py 做预打包:每个字做 4 倍噪点增广(平移、微旋转、高斯噪声),64×64 灰度。全量 21 个字打包出来 48k 张、197MB——6GB 显存放不下全量 batch,预打包比每次在线增广省事。
两种生成器
条件生成意味着 z → 图像的映射还要吃一个字标签。试了两条路:
扁平噪声 + MLP(ConditionalMLP):32 维高斯噪声和 64 维字嵌入拼接,三层 1024 隐层直接出 4096 维像素,Tanh 收尾。最后一层用 final_init_std 控制初始输出幅度——初始时让输出接近某个”伪图像”而不是纯随机,对 drifting 场的起步很重要。
空间噪声 + 转置卷积(ConvGenerator):论文里强调生成器应该吃空间结构化的噪声(patchified 32×32×4)而不是扁平向量——扁平噪声会让每个 z 塌到同一个类中心团块。所以这个版本用 8×8×64 的噪声图,字嵌入投影成空间偏置加进去,再过转置卷积逐级上采样到 64×64。
class ConvGenerator(nn.Module):
    def forward(self, z, char_idx):
        h = z.view(-1, self.noise_ch, 8, 8)
        h = h + self.proj(self.embed(char_idx))[:, :, None, None]
        h = self.ups(h)          # 8 -> 16 -> 32 -> 64
        return self.out(h).flatten(1)
当时的计划是:MLP 做像素基线,ConvGenerator 做主力,另外再开一条特征空间的路线。后来的剧情是——基线活了,主力反而没跑赢。
第三章:特征空间的连环翻车
像素空间直接回归 4096 维总觉得不够优雅,第一反应是找个更好的表示空间算 drifting 场。这个方向试了四五个变体,全军覆没,而且失败方式各不相同,值得逐个记录。
| 配置 | 结果 |
|---|---|
| 自训 conv AE 特征空间 | ❌ AE latent 退化为无信息(tanh 瓶颈的局部解) |
| 冻结随机卷积特征 | ❌ 高频梯度 → 椒盐噪声 |
| 预训练 ResNet18 特征(单项) | ❌ 纹理欺骗编码器:特征匹配但像素是噪声 |
| ResNet18 + 像素锚 双项损失 | ❌ 发散(val loss 3.3) |
| 逐类稠密负样本 / 固定粒子库 | ❌ 收敛到类中心伪平衡(drift → 0) |
| 像素空间,τ = 0.02 / 0.01 | ❌ softmax 饱和,崩成噪声 |
几个失败值得展开说。
自训 AE 的退化最隐蔽:loss 正常下降,训练曲线看起来一切健康,但生成的 latent 全挤在一个小区域——AE 自己先塌了,drifting 场在一个没有信息的空间里推来推去,推了个寂寞。
ResNet 特征被骗最有意思:生成样本在 VGG/ResNet 特征空间里距离数据点很近,损失很低,但解码回像素一看全是噪声纹理。特征编码器是冻结的,它只对纹理统计敏感——生成器学会了制造”在特征空间里像数据”的纹理,绕过了任务本身。这说明特征空间的 drifting 场必须和像素项联用,但两项联用在我们的 batch 规模下又不稳定,直接发散。
逐类负样本的伪平衡是理论上最有教益的失败:条件生成时很自然地想”每个类内部自己做吸引排斥”,但这么做之后每类的生成点会迅速挤向类中心然后停止移动——类中心是 drifting 场的结构性不动点,loss 降到很低,分布却根本没对齐。
回头串起来,根因其实 toy 那节已经写了:2D 成功是因为 z → 最近簇的指派函数平滑,网络拟合得起;图像空间里这个映射是混沌的,硬核(小 τ)追噪声,软核(大 τ)输出软平均。drifting 场在图像空间没有给网络留出一条可以平滑跟随的路径。
第四章:像素空间的最后结果
配置
关掉所有花活,回到最朴素的配置:像素空间 4096 维、MLP 生成器、全局场(一个 batch 里 10 个数字混在一起做吸引排斥,不按类拆)、τ 自适应(0.05 · 平均距离)、batch 2048、lr 1e-4:
model = ConditionalMLP(num_chars=10, in_noise_dim=32, embed_dim=64,
hidden=1024, out_dim=64 * 64, final_init_std=0.5)runs_mixdrift_digits_mlp_v1/,6000 步,训练时间约 6 分钟。
结果
生成样张(10 类 × 8 个随机 z):
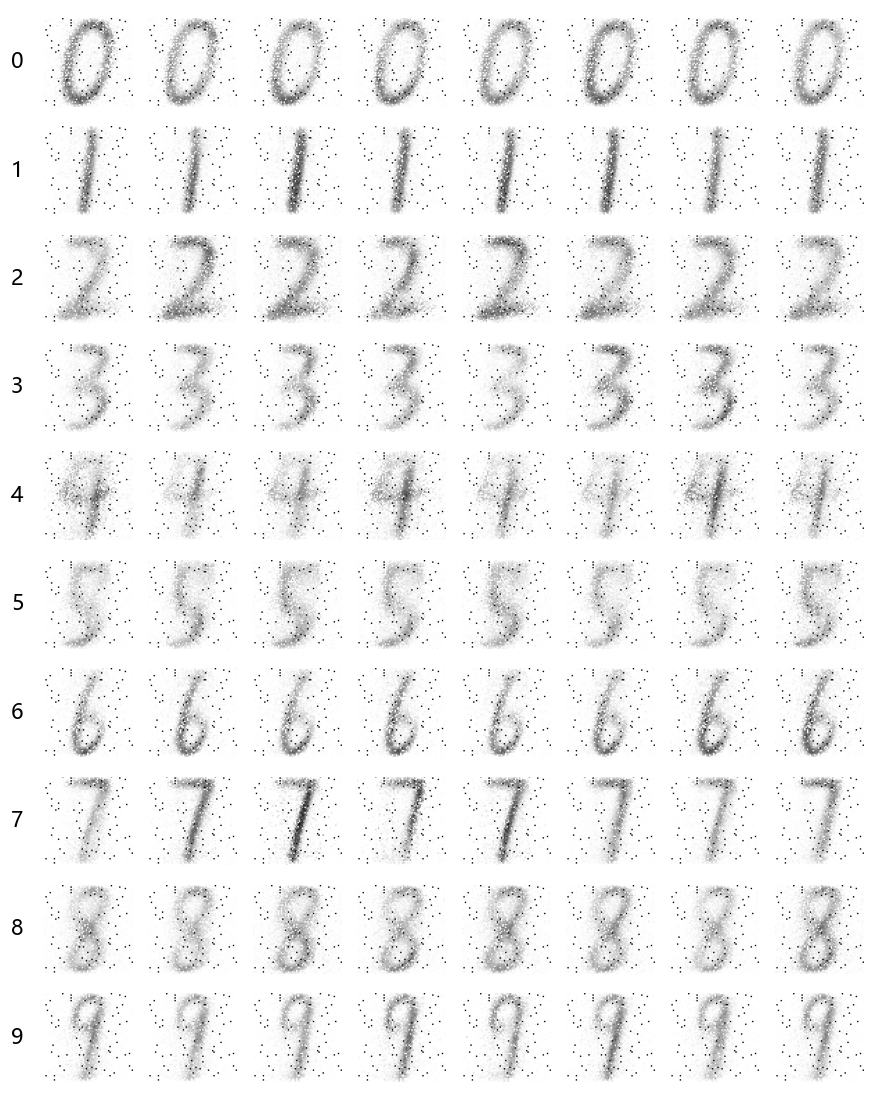
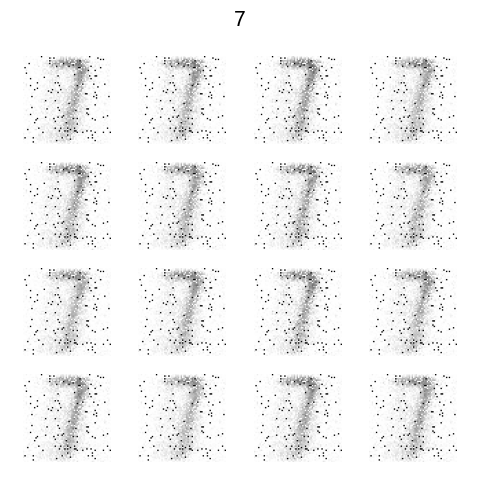
0-9 全部清晰可读,类内形态有明显随机变化(不同的 7、不同的 2),不是类均值复制。单字生成的效果:
训练动力学的几个数字:loss 从 5.8e-7 一路降到 6e-8 量级,drift 范数从 0.048 收敛到 0.015 附近——场在趋于零,符合”分布对齐 → V=0”的理论预期。更重要的是 val_drift 全程贴着 train_drift 走(0.015 vs 0.015),48k 张的增广数据没有出现过拟合迹象。
为什么数字清晰而汉字发糊
同样的管线跑了 10 个汉字(含心)的版本(runs_mixdrift_chars_10c_v1/),字形可辨但明显发糊。原因不在实现,在数据本身:
- 数字 0-9 的类内形态高度一致,类均值 ≈ 一张干净的数字
- 汉字书写变化大,类均值天然发虚
纯像素 MSE 回归(drifting loss 本质上还是回归)收敛到条件均值是它的固有属性。 toy 里瑞士卷拟合得好,是因为流形低维且光滑;汉字的类内分布是个高维散布的集合,均值落在流形之间的”空地”上。
所以这个实验的诚实结论是:drifting 一步生成在类内一致性高的数据上可以直接出可用结果,在书写变化大的数据上需要先把类内方差降下来(选书写风格接近的样本子集),或者把场搬到既能保语义又不受纹理欺骗的表示空间——后者正是第三章翻车的地方。
第五章:复盘
这次学到的
sanity check 的钱不能省。 toy 2D 花的时间不到图像实验的十分之一,但”loss 实现已验证正确”这个结论让后面所有失败都能归因到数据/空间,而不是怀疑实现有 bug。第三章连环翻车的时候,如果没有 toy 的底,大概率会在实现层面反复打转。
多峰数据的类中心是 drifting 场的伪平衡点。 逐类场、固定粒子库的失败都指向同一件事:场为零 ≠ 分布对齐,只保证推力等于斥力。类中心就是这样一个处处平衡的位置。全局场反而避开了这个问题——10 个类混在一起时,跨类的排斥把生成点从单类的类中心上拽开了。
一步生成的代价优势是真实的。 6 分钟训练 + 一次前向生成,这个成本结构对端侧部署很有吸引力,值得在修复类任务上继续验证——这是下一篇文章的主题。
若要继续
按性价比排序:
- 汉字清晰化:类内选样把方差降下来,类均值即接近清晰字形
- 预训练特征 + 像素锚的权重扫描(0.1 / 0.3 / 1.0),配合 lr 退火
- 混合温度 τ ∈ {0.02, 0.05, 0.2} 求和,让场同时有细节和全局
本系列研究借助了 AI 工具辅助思路梳理和代码实现。